标签归档: 自托管

给 NAS 搭了个 AI 运维管家:Go 盯告警,OpenCode 干活,主路由负责互检

最近折腾了一套家里的 NAS 运维助手,暂且叫 HomeOps。机器是 GKN6000 NAS,加一台 J4125/OpenWrt 主路由,上面已经跑着 Gitea、Nextcloud、Vaultwarden、Home Assistant 等服务。

起因很简单:出了安全事件,希望有人早点发现;软件该不该更新,希望有人先查清楚兼容和迁移;服务凌晨挂了,也不想只收到一句“异常/已恢复”,还得自己翻半天日志。

最开始想在两台机器上各塞一个 Agent,让它们互相检查。后来拆成了两层:Go 程序持续做固定检查,出现事件再叫 Agent 分析。

现在的结构
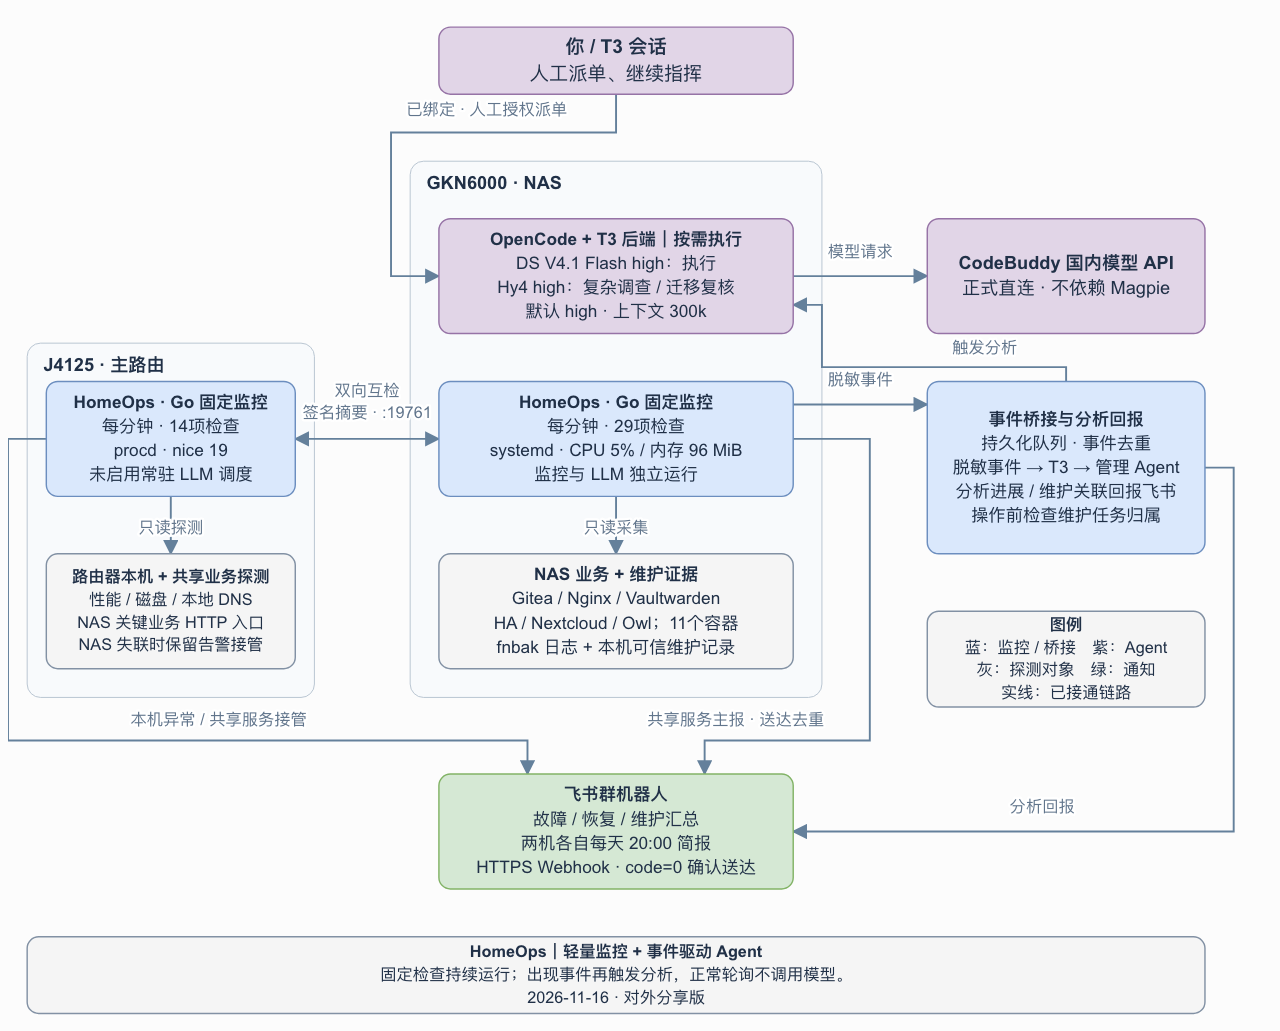
HomeOps 双机部署与事件驱动 Agent

  • NAS:固定监控 + OpenCode 管理 Agent + T3 任务入口。
  • 主路由:轻量固定监控,检查自己的资源、DNS,以及 NAS 的服务和监控进程。现在没在主路由上跑常驻 LLM 调度。
  • 飞书:接收告警、恢复、备份汇总、每日简报,以及 Agent 的分析进度和结论。
  • 模型:CodeBuddy 国内官方接口直连。日常执行用 DeepSeek V4.1 Flash,复杂安全调查、迁移及回退方案复核交给 Hy4。当前默认 high,上下文配置 300k。

T3 Code 主要用来接远程任务、保留会话上下文;真正执行工具的是 OpenCode。模型推理在云端,NAS 跑探针、执行器和工具。

为什么固定监控不用 AI

我最担心的问题是:如果 Agent 把自己所在的机器玩坏了,谁来发现?

所以两台机器各自运行独立的 Go 监控,不依赖模型、Agent 会话或我这台电脑。NAS 平时负责共享服务的主报告,路由器保留接管能力;不能因为对面的进程还活着,就永远相信它已经发出了通知。

普通检查按分钟跑,覆盖内存和磁盘、业务 HTTP、DNS、预期容器是否存在/运行/健康、对端采样是否新鲜。CPU、负载等数据累计到每日简报。Nextcloud 还会看 status.php 的语义,不能随便一个 200 就算健康。

固定监控这层此前一次约 70 秒的空闲采样,两个进程的 RSS 都在十几 MiB,平均单核 CPU 约 0.03%。这个数字只对应探针,不是 Agent 执行任务时的资源占用。NAS 探针设了 5% CPU、96 MiB 内存上限;主路由保留低优先级运行。
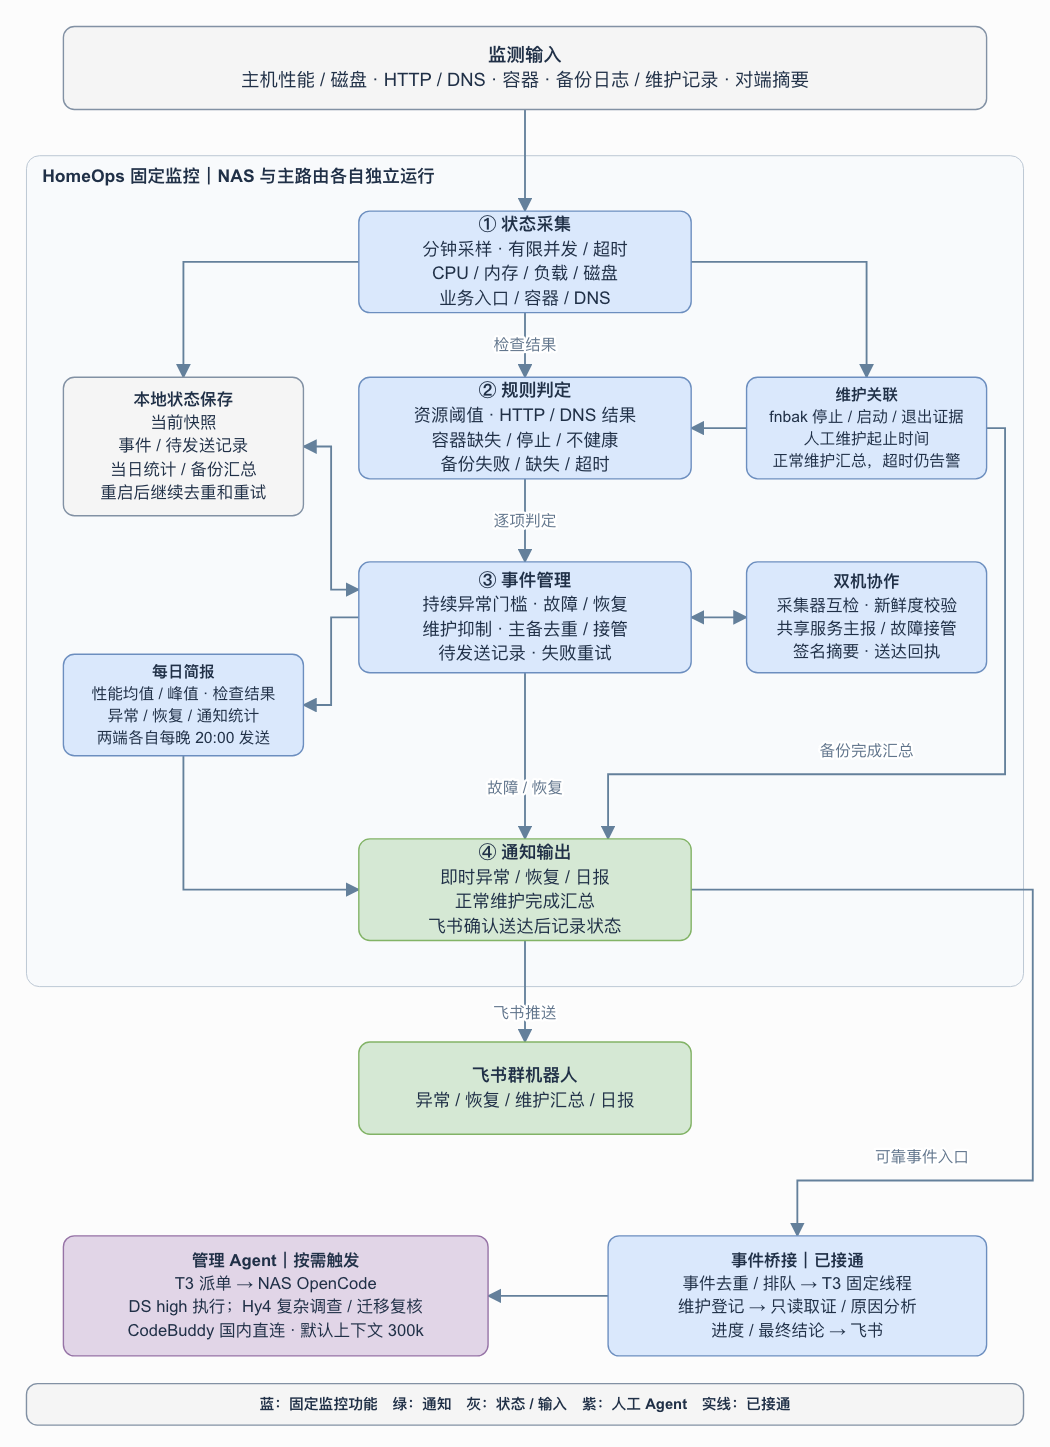
HomeOps 功能框图

告警之后,Agent 怎么接上

现在已经接通了这条链路:

固定探针确认事件
  → 桥接先写本地队列,再投递脱敏事件
  → T3 固定会话排队 / 去重
  → OpenCode Agent 查证据、关联维护任务
  → 飞书回报进展和结论
  → 我可以在原会话里继续指挥

健康轮询不调用模型。故障和恢复带事件标识,通知失败、进程重启后继续处理。也区分“已投递”“正在分析”和“分析完成”,不把 webhook 收到请求当成 AI 已经解决问题。

飞书目前是通知出口,还没做成从群里双向控制整套系统。

踩过几个很实际的坑

1. 凌晨 Gitea 异常,最后是备份主动停的

第一次收到的是两台机器分别发“异常”,过一会儿再分别发“恢复”。看起来很热闹,信息量却很少。

查完发现,每天 04:30 的一致性备份会主动停 Gitea,备份完再启动。现在读备份日志里的实际开始、停止、启动和退出结果,关联到维护窗口;正常只汇总一次,失败或超时照样告警,而不是每天固定把 04:30 静音。

顺便还踩了个解析坑:真实日志的时间戳有 CST 后缀,合成样例里没带,测试都绿了,现场却读不到周期。

成功通知最后压成了这样:

[HomeOps] NAS 备份完成
04:30:11–04:33:35,耗时3分24秒。
Gitea停服2分1秒。

2. 多个 Agent 会互相“帮倒忙”

一个任务正在迁移数据库,另一个告警 Agent 看到服务停着,很容易热心地去拉起它。

后来加了一个按检查项登记的维护归属:哪个任务正在动什么服务,操作前先查;同一检查被其他任务持有就停止写操作,不能到期了直接抢。分析 Agent 先关联负责的维护任务,再说明这是预期停机还是额外故障。

这比在每个提示词里重复一句“谨慎操作”具体得多。

3. 升级的重点经常是迁移和回退

我让 Agent 做 Gitea 升级时,花时间的主要是配置弃用项、数据库迁移、一致性备份、隔离恢复和回退预演,以及升级后的真实 Git 读写验收。拉个新镜像反而是最简单的一步。

所以复杂调查、迁移方案和执行分开处理。不能因为一个健康接口恢复了,就把整个迁移当验收完成。

4. 提示词规则不是权限隔离

隔离工作区和宿主管理实例分开。管理 Agent 现在默认普通用户,必要时可 sudo;有能力管理整机,也意味着权限很大。维护登记只是协作约束,不是一个能拦截所有 shell 的安全沙箱。

我更愿意让固定探针保持独立,把授权、备份、操作记录和回退过程做实,而不是给它一句“你是专业运维专家”就放心睡觉。

还在继续补的部分

目前已经有固定监控、双机互检、维护关联、事件到 Agent 的分析回报,以及人工继续下指令的入口。完整入侵检测、安全公告/漏洞的持续跟踪、SMART 和恢复演练还没做齐。两台机器同处家里,断网或停电也仍有盲区,后面还需要外部探测。

这两天做下来,最费精力的不是选哪个模型,而是让通知有用、任务不互相打架、出问题时能知道谁正在做什么。

如果你也在家里把 Agent 接到 NAS / 路由器做运维,会把哪些动作开放给它,哪些还坚持手动?

TencentDB Agent Memory 与 Hy Memory 对比

在同一台电脑上跨 Codex、WorkBuddy、Hermes 和 OpenCode 复用历史,优先看 Hy Memory/MemHub。个人要在 Mac 和 Windows 间共享记忆,则值得优先验证 TencentDB Agent Memory。多人共用项目 Wiki、代码索引、可复用 Skill,或把独立 CodeBuddy 纳入统一记忆入口,TencentDB Agent Memory 更贴合。 这是根据源码、文档与发行记录作出的场景判断。两套系统均未在本机部署,也没有用同一组会话做对照测试。

腾讯云版如何工作

  • 入口是模型代理。 Agent 把模型请求指向 Memory Proxy。代理按用户凭据识别身份并解析 Team → Agent → Task 绑定,在适用的请求上注入已授权记忆,再调用配置的上游模型。启用归档后,会话进入 Memory Core。历史会话也可以单独导入,例如 Codex 的导入工具可按目录选取本地 session。 Codex 代理源码 · Codex 历史导入
  • 对话按四层组织。 L0 保留原始对话,L1 提炼事实、偏好和约束,L2 按场景组织知识,L3 形成长期画像。L2/L3 用于快速恢复上下文,精确查询可沿关键词和向量召回查回 L1/L0,以 RRF 合并排序。 架构说明 · 召回实现
  • 知识和经验可以单独分发。 Chat Memory、Skill、LLM-Wiki、CodeGraph 都作为资产管理。Skill 沉淀可重复执行的做法,Wiki 从文档构建可查询的页面,CodeGraph 从仓库索引文件、符号和调用关系。Wiki 和 CodeGraph 异步构建,Agent 可用 /v3/tools/list 和 /v3/tools/call 按需查询。v2.0.3 已含富文档导入,变更日志也记录了私有仓 SSH 建图,实际凭据和构建链路仍需验收。 Knowledge OpenAPI · 变更日志
  • 资产权限和 Agent 绑定分别判定。 源码对 private 只允许 owner 访问,对 restricted 的普通成员要求匹配 ACL,团队管理员仍可凭角色获得部分操作权限。固定绑定另有规则,当前 canBindAsset 拒绝绑定 restricted 和 task 资产。试用时应分别验证面板读取、工具调用与代理注入。 权限判定源码
  • 可自托管。 Docker 入口启动 Core、Hub(Panel + Knowledge)和 Proxy。默认 SQLite 持久化,MongoDB 是可选实验后端。安装分别配置记忆处理模型和对话上游,两组可复用。通过代理的模型请求会流向所配上游,其中可能包含注入的记忆。 安装指南 · 容器部署

与 Hy Memory/MemHub 对比

维度 TencentDB Agent Memory Hy Memory/MemHub
产品定位 团队服务,给不同成员、Agent 和任务分配可共享的资产 Hy Memory 是 Python 记忆引擎,MemHub 是本地优先的桌面/CLI 产品,汇总获授权的历史并提供跨工具召回
采集与召回 代理采集新流量并按绑定注入。历史会话有独立导入入口 主要靠已授权的日志扫描、Hook/插件采集。通过 MCP/Skill 主动查询,部分宿主支持自动召回
记忆结构 L0–L3 对话记忆,另有 Skill、LLM-Wiki、CodeGraph Chat 的分层长期记忆、Working 的事实与经验、Coding 的经验和代码版本演化链
代码与文档 CodeGraph 回答仓库里符号在哪里、有哪些调用、修改影响哪里。Wiki 支持团队分发 Coding diff 链回答某次任务中的代码怎样演进、有哪些可复用经验。两者的图和链服务于不同查询
权限与部署 用户 Key、团队角色、资产可见性、ACL 与固定绑定。代理进入模型请求链路 来源采集、模型处理和宿主 Recall 分开授权。现有宿主仍可用原模型通道,选用外部记忆模型时会发送相关的授权内容。主分支另有 CLI/API 多用户能力,发行状态见下
开源许可 MIT Apache-2.0

腾讯云版架构 · Hy Memory SDK 架构 · MemHub 授权与宿主支持 · MemHub 隐私说明

五个常见 Agent 的接入方式

Agent 腾讯云版接入 MemHub v1.0.5
Codex 自定义 Responses provider。首次交互绑定文档要求 Plan 模式,v2.0.3 增加用户级默认绑定。桌面端实际会话、流式工具和会话恢复待测。 接入说明 扫描/Capture Hooks 写入,MCP + Skill 主动召回,无自动 Prefetch。 接入说明
独立 CodeBuddy 有 ~/.codebuddy/models.json 接法。文档注明 4.10.2–4.10.4 缺少 sessionId,无法完成初始化。独立 CLI/IDE 各自待测。 接入说明 支持矩阵仍未列独立 CodeBuddy。WorkBuddy 的插件格式名和目录覆盖变量不能证明独立版已接通。 支持矩阵
WorkBuddy Desktop 用 Responses,Web 用 Chat Completions。 接入说明 插件 Hook 可自动注入,另有 MCP + Skill 主动查询。 接入说明
Hermes 自定义上游走 Proxy,用请求头预选 Team/Agent/Task。 接入说明 v1.0.5 已提供原生只读 MemoryProvider 自动 Prefetch,并占用唯一的 memory.provider 槽位。会话写入仍由扫描负责。 接入说明
OpenCode v2.0.2 起有官方 provider 配置,记忆链路依赖适配器的路由标记。 接入说明 MCP 主动查询,DB 扫描/JS Capture Plugin 写入,无自动 Prefetch。 接入说明

个人跨机器共享同一份记忆

以一台 Mac 和一台 Windows 交替或并行工作为例。MemHub v1.0.5 有 macOS arm64 版本,Windows 无官方制品。若试 TencentDB,两端各开独立会话,在服务端绑定同一份项目记忆。并行试验用两个不同事实,再分别开新会话验证双向召回及落库时间。记忆的后台提炼有延迟,进行中的同一聊天、工作区文件和未提交改动需要各自的同步方式。 MemHub 平台支持 · Codex 会话标识

  • 常在线、自动采集和召回。 两者中优先验证 TencentDB。把一套服务放在常在线主机上,各设备通过 Tailscale 将受支持 Agent 的模型入口指向同一 Proxy,并使用同一个个人账号和同一个 Agent 绑定。这样,通过代理的会话可以汇入同一库,各设备也可以从同一库召回。未经过 Proxy 的历史需另行导入。主机或网络中断时,走这个入口的模型请求也受影响。 局域网/多机部署说明
  • 保留各机器原有模型通道或需要离线。 MemHub v1.0.5 的产品接入围绕本机 Runtime、loopback Broker 和单写锁设计。未核实多台 MemHub 自动双向合并记忆的产品能力。Hermes 可通过自行管理的 Hy Memory HTTP 服务做远程召回,但需要鉴权网关,且仅覆盖该接法。Nextcloud 可同步普通 Markdown 交接笔记,运行中的 MemHub 数据目录不适合作为多机共享目录。 MemHub Runtime 架构 · Hermes 远程直连接入边界

核验依据与适用场景

  • 版本。 腾讯云版公开最新 Release 为 v2.0.3(10 月 26 日),源码核验 2002196。MemHub 公开最新 Release 为 v1.0.5(10 月 28 日,绑定 SDK 2.0.8),有 macOS arm64 App/Runtime 和 Linux x64/arm64 Runtime。Hy Memory 主分支 2f9e028 已写 MemHub v1.0.6/SDK 2.0.14,但截至 11 月 5 日查询 GitHub Releases API 返回 404,远端也未见 v1.0.6 tag,因此按主分支能力记录。 腾讯云版 Release · MemHub 公开 Release · MemHub 主分支版本说明
  • 效果证据。 腾讯云版 README 自报 PersonaMem 从 48% 到 76%(+28 个百分点)。Hy Memory 提供 Chat 长期记忆和 CMB 编码记忆研究。现有资料不足以做同模型、同题集、同成本的横评,也没有本机延迟、记忆准确率或权限隔离实测。 腾讯云版 Benchmark · Hy Memory 论文与基准
  • 团队试点。 如果需要跨人共享项目上下文,可用一个脱敏仓库、一份文档、两个普通账号,先验证独立 CodeBuddy → 腾讯云 Proxy → 新 Codex 会话的跨工具接力,再检查未授权账号能否从面板、工具或注入结果读取同一资产,同时观察流式工具调用和 Proxy 异常时的行为。个人试用可先接 Codex 与 WorkBuddy,用少量历史检查召回、原文追溯和撤权。 MemHub 宿主接入说明